Pipeline Preditivo no Competitivo e ML Engine
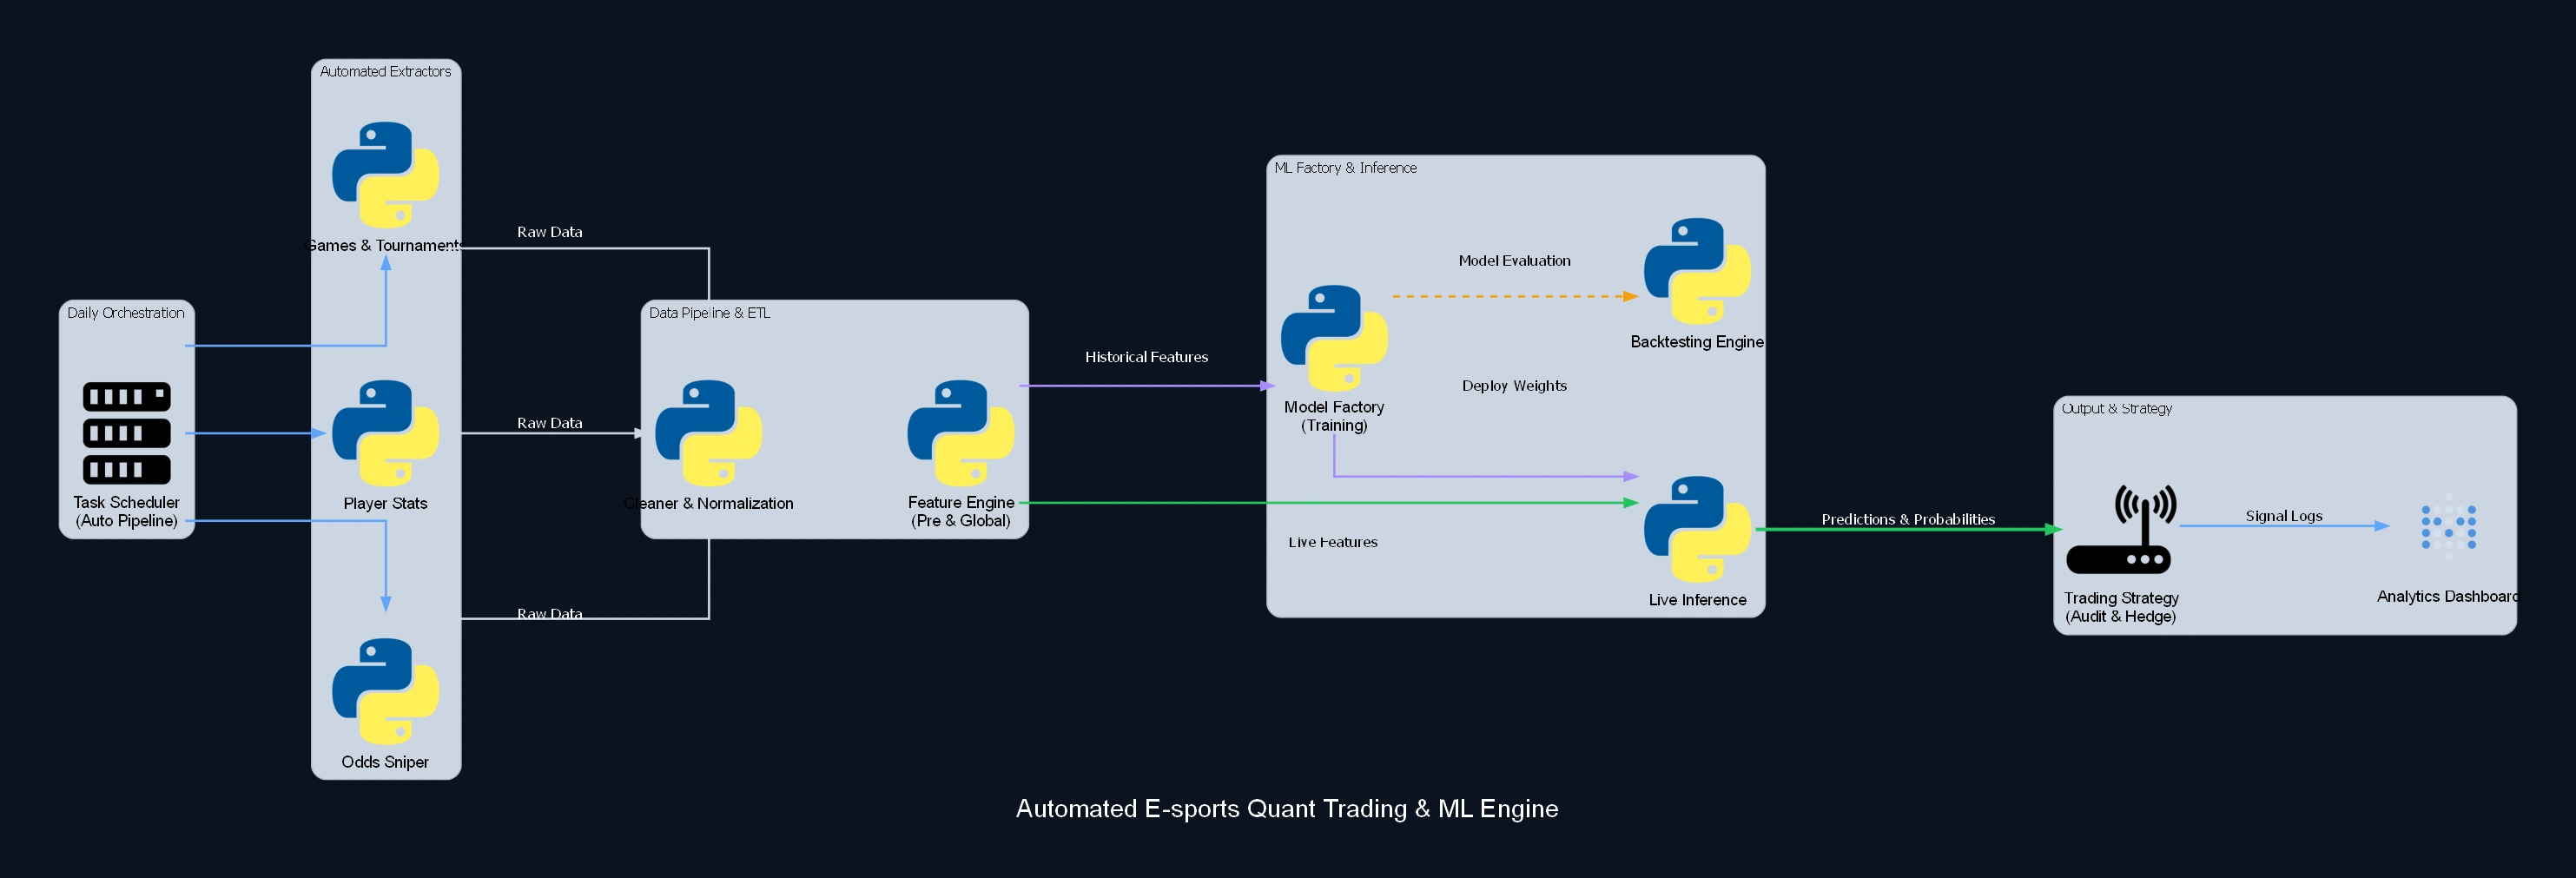
Motor algorítmico end-to-end orquestrado para trading quantitativo, com modelo preditivo validado acima de 68% de precisão ao longo de múltiplas temporadas. A arquitetura engloba web scraping massivo diário, normalização rigorosa e uma Feature Engine otimizada que alimenta a 'Model Factory' com 42 variáveis estruturais. O sistema gerencia autonomamente o retreinamento (backtesting) e a inferência ao vivo, enviando sinais de alta precisão para estratégias de hedge e dashboards.
Estudo de caso
Problema
Decisão preditiva em janela volátil sem ingestão automatizada: partidas e torneios, estatísticas de jogadores e odds vinham de fontes web separadas, em formatos distintos, sem normalização nem histórico comparável para treinar e avaliar o modelo.
Solução
Orquestração diária por Task Scheduler acionando três extratores automatizados; ETL de limpeza e normalização alimenta uma Feature Engine isolada (Pre & Global) que produz 42 variáveis estruturais. As features históricas treinam a Model Factory, cujos pesos passam pelo Backtesting Engine antes de serem publicados para a inferência ao vivo, que consome as mesmas features em tempo real.
Impacto
Treino e inferência compartilham a mesma definição de variável, e o ciclo de retreinamento, backtest e publicação de pesos roda sem intervenção manual: o modelo sustenta >68% de precisão preditiva ao longo de múltiplas temporadas, com predições e probabilidades alimentando a estratégia de hedge auditada e o dashboard analítico.
Precisa de um motor preditivo alimentado por feature engineering isolado? Vamos desenhar essa arquitetura no seu contexto.
Falar sobre seu caso